一条飞书消息,如何让本地 Hermes 把任务交给另一台服务器上的 Hermes,调用远端专用 Skill 完成官网内容操作,再把结果送回当前会话?
本文记录一条已经实际运行的跨服务器协作链路。案例中的发起方就是当前“AI创意”机器人,执行方是另一台服务器上的公司内容机器人。公开版已经隐藏主机名、端口、账户、路径、Token 和会话身份。
说明:本文描述的是基于 Hermes Gateway、OpenAI 兼容接口、SSH 本地端口转发和项目级包装器搭建的本地实践,不代表 Hermes 上游提供了开箱即用的“跨服务器机器人集群”产品。不同版本的接口、配置和安全边界可能变化,部署时应以当前 Hermes 官方文档和实际代码为准。
案例背景:一台服务器不必承担所有角色
当前业务有两个职责不同的 Hermes Profile:
- 本地业务机器人负责理解飞书指令、确认授权范围、整理最终产物和向用户反馈;
- 远端公司内容机器人拥有自己的角色设定、Skill、内容资料和官网发布能力。
如果把所有职责都塞进一个机器人,它需要同时掌握聊天上下文、内容生产、网站接口、账号状态和发布安全,权限会越来越宽,故障也难以隔离。
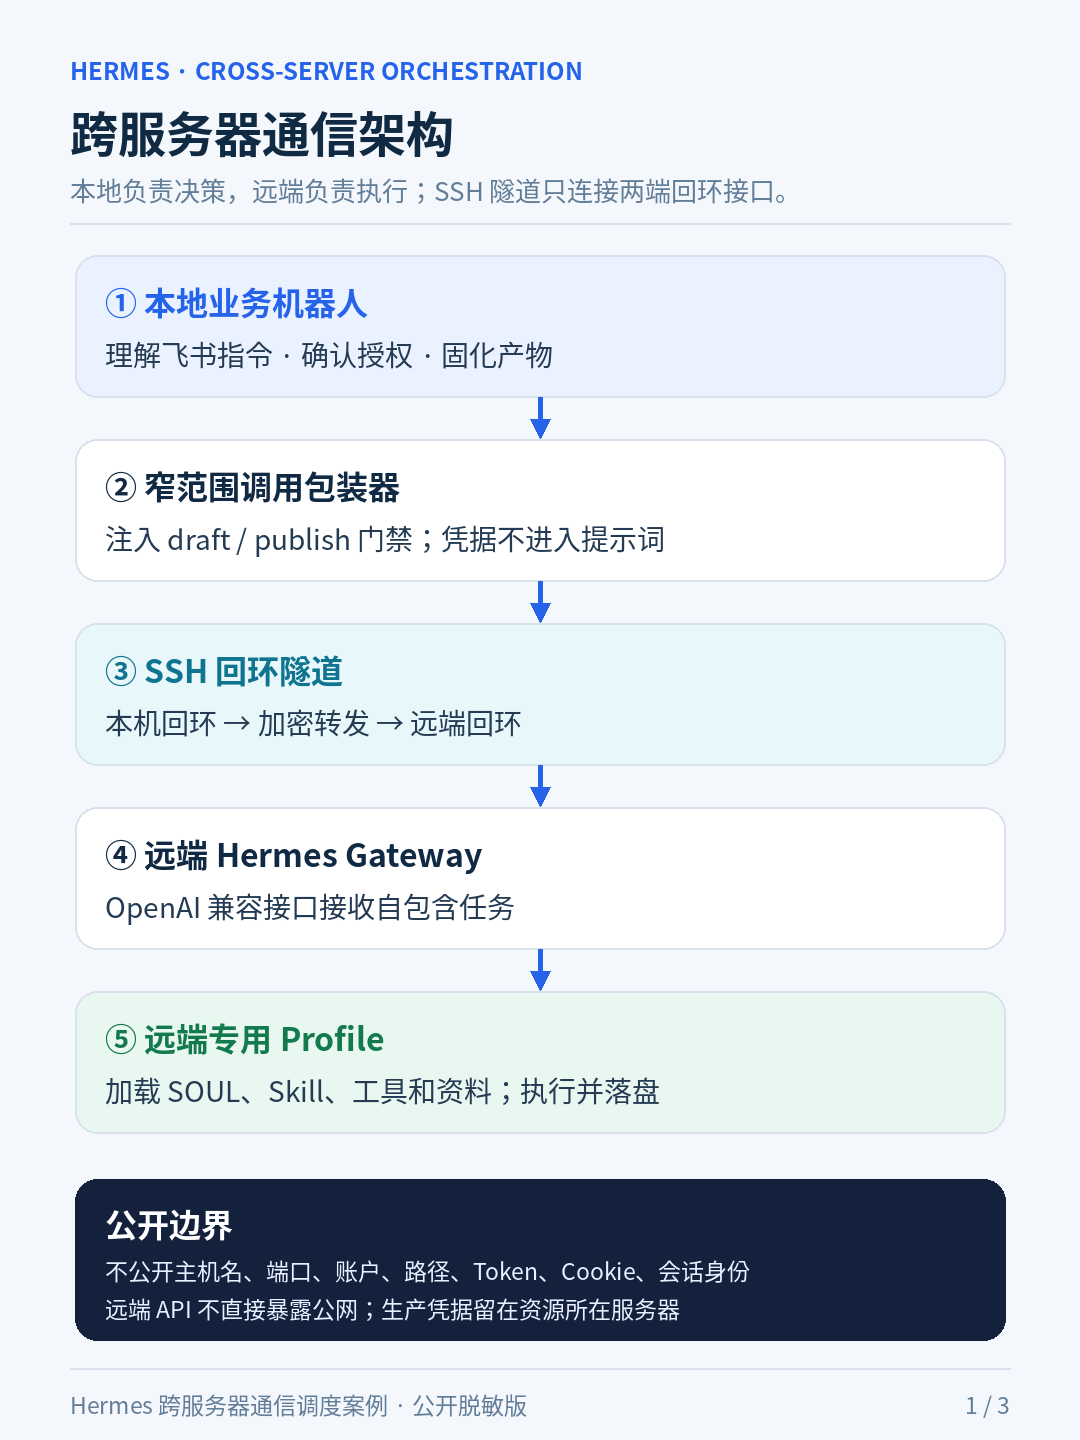
跨服务器协作把两者拆开:本地机器人只负责“决定做什么”,远端机器人负责“在自己的服务器上怎么做”。
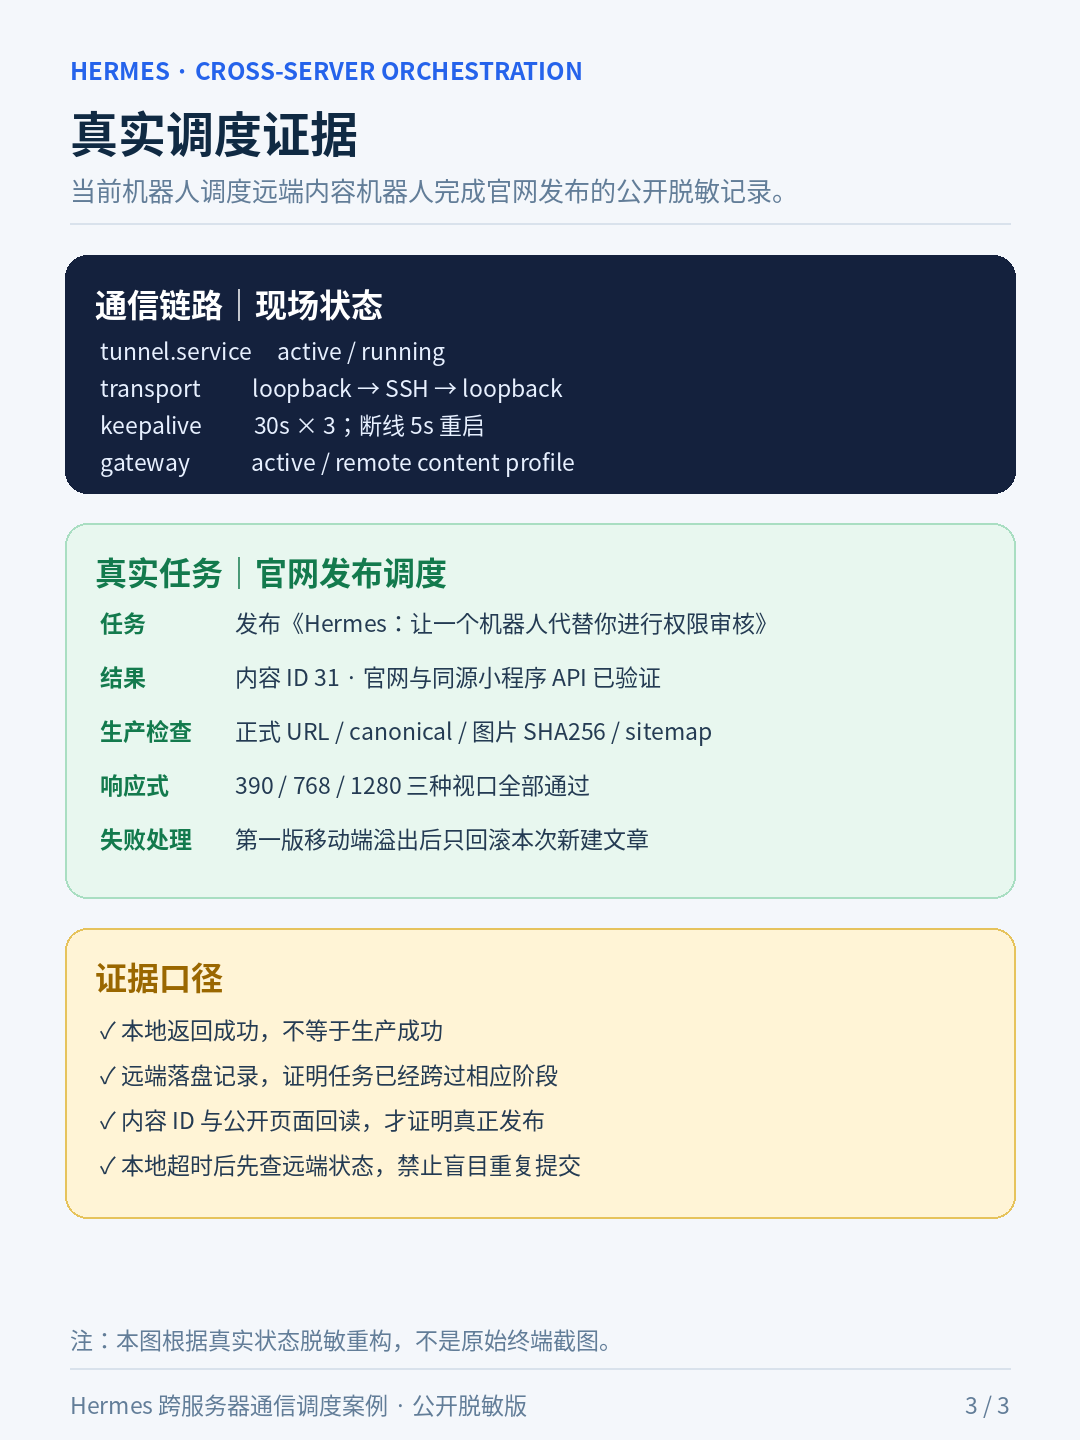
本案例实际完成的任务,是把《Hermes:让一个机器人代替你进行权限审核》发布到官网及同源小程序接口。最终生产记录为内容 ID 31,官网、列表、sitemap、小程序 API、图片与 390/768/1280 三种视口均完成回读验证。
第一层:业务机器人负责任务编排
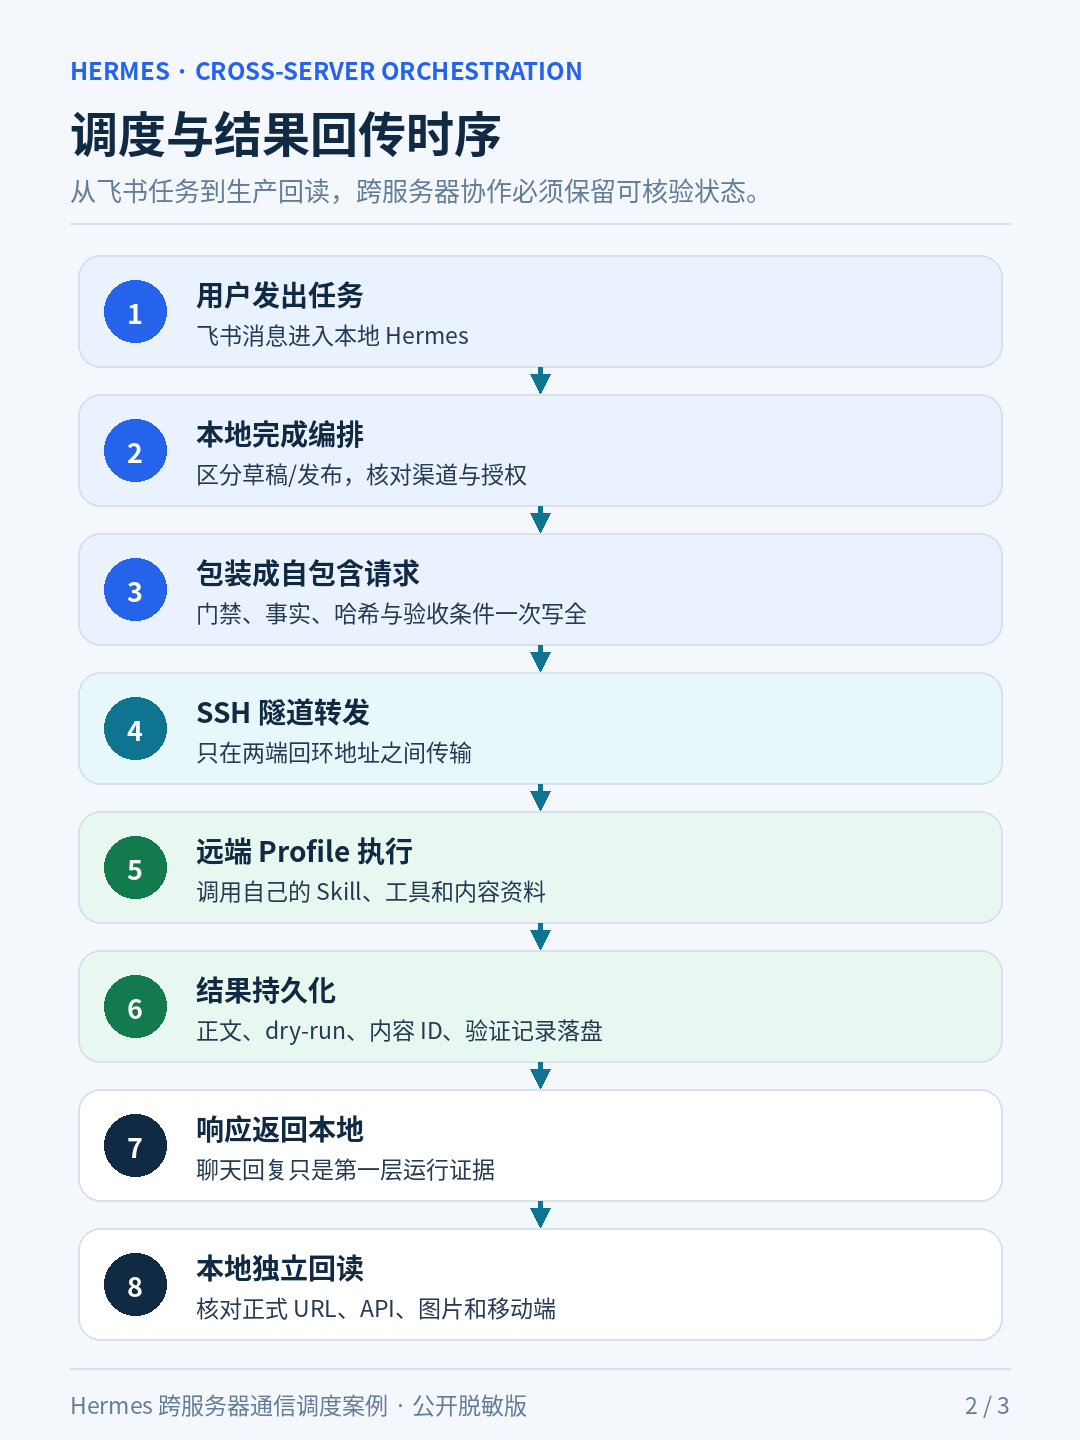
用户在飞书中给本地 Hermes 下达自然语言任务。本地机器人先完成四件事:
- 判断任务是内部草稿还是生产发布;
- 核对正文、图片、目标渠道和自动关联渠道;
- 把必要上下文整理成自包含任务;
- 调用窄范围包装器,不直接操作远端网站凭据。
包装器提供两个模式:
draft    只允许内部草稿与检查
publish  必须已有明确发布授权
草稿模式会在任务前自动加入“不得修改生产环境、公开发布或向第三方发送消息”的门禁。发布模式也不是无限放行,它仍要求远端机器人核对目标内容、渠道、事实来源和回滚条件。
因此,模式参数控制的是任务边界,不是绕过安全检查的开关。
第二层:SSH 隧道承载跨服务器通信
本地包装器请求的是一个回环地址,而不是远端公网地址:
本机回环端口
  ↓ SSH 本地端口转发
远端回环端口
真实链路由 systemd 用户服务维护。公开化后的关键配置如下:
[Service]
ExecStart=ssh -NT \
  -o ExitOnForwardFailure=yes \
  -o ServerAliveInterval=30 \
  -o ServerAliveCountMax=3 \
  -L 127.0.0.1:<本地端口>:\
127.0.0.1:<远端端口> \
  <远端主机别名>
Restart=always
RestartSec=5
这个设计有三个直接好处:
- 远端 Hermes API 只监听远端回环地址,不必直接暴露到公网;
- SSH 负责加密和主机认证,业务提示词不需要携带 SSH 密码或私钥;
- systemd 在隧道断开后自动重启,心跳连续失败时会主动重连。
在本次证据采集时,本地隧道和远端 Gateway 都处于 active/running,隧道服务自当前启动以来重启次数为 0。
第三层:远端 Gateway 把请求交给指定 Profile
隧道另一端是远端 Hermes Gateway 的 OpenAI 兼容接口。包装器发送的请求结构可抽象为:
{
  "model": "hermes",
  "messages": [
    {
      "role": "user",
      "content": "门禁 + 完整任务"
    }
  ],
  "stream": false
}
认证信息由包装器从独立凭据文件读取,只进入 HTTP Authorization 请求头,不写进任务描述,也不回传给聊天会话。
远端 Gateway 收到请求后,加载指定内容 Profile 的:
- SOUL 与角色边界;
- 模型配置;
- 可用工具;
- 内容写作和发布 Skill;
- Profile 内的历史资料与工作目录。
当前包装器按单次任务调用,不自动继承本地飞书聊天记录。因此,本地机器人必须把目标、事实、授权、产物哈希和验收条件一次写完整。需要长期连续维护同一任务时,才适合进一步使用固定 Session Key 和持久 Session ID。
第四层:结果不是一句“成功”,而是一组可核验状态
远端 Hermes 完成任务后,会通过 OpenAI 兼容响应返回文字结果。但对生产任务来说,聊天回复只是第一层证据。
本案例还要求远端持久化:
- 最终正文和元数据;
- dry-run 结果;
- 固定发布器及其 SHA256;
- 发布前查重结果;
- 内容创建响应;
- 内容 ID 和正式 URL;
- 发布后网站、小程序和图片回读;
- 390、768、1280 三种视口的几何检查。
本地机器人再独立访问正式 URL 和公开 API,确认远端机器人报告的 ID、标题、图片和状态与生产事实一致。
这形成了三层证据:
远端聊天响应
  ↓
远端持久化结果
  ↓
本地独立公开回读
只有第三层也通过,才能向用户报告“已经发布”。
一次真实调度经历了什么
这次发布并不是一次请求就毫无波折地结束。
第一版文章成功创建了生产记录,但 390px 下长代码行触发了文章模板的 flex 最小宽度问题,正文被撑宽。发布器按预设条件只回滚了本次新建文章,没有删除已校验的脱敏图片,也没有触发公众号、头条或知识库分发。
随后本地机器人根据生产几何数据生成移动安全版:
- 缩短公开标题;
- 把内部绝对路径改为仓库相对路径;
- 把长命令拆成短行;
- 把 YAML 示例限制在移动端安全列宽;
- 重新锁定正文、元数据、预检和发布器哈希。
第二版执行一次 publish-once 后成功创建内容 ID 31,并通过全部生产回读。
这也说明跨服务器调度不是简单的“远程执行命令”,而是一个有状态的工作流:
授权 → 固化产物 → dry-run
→ 单次写入 → 持久化 ID
→ 多表面回读 → 成功或回滚
为什么本地超时不等于远端失败
跨服务器调用中,本地包装器有等待上限。调用超时只说明本地不再等待,不代表远端 Agent、浏览器或发布器一定停止。
如果不检查就重试,可能出现重复草稿、重复文章或重复提交。
正确处理顺序是:
- 检查远端是否仍有相关进程;
- 检查持久化结果文件是否已经生成;
- 查询内容管理接口是否已有非零 ID;
- 回读正式页面和发布状态;
- 只有确认没有跨过写入边界,才允许重新发起。
本案例中就出现过本地等待超时、远端产物已经落盘的情况。最终状态以远端持久化文件和公开页面为准,而不是以本地调用是否在时间内返回为准。
性能教训:远端机器人应做执行器,而不是反复做编辑器
最初流程把正文整理、图片检查、发布器生成、响应式验证和故障诊断都交给远端 Agent,每个阶段都重新启动一次推理,导致一次发布需要等待多轮远程调用。
优化后的快速通道是:
- 本地完成正文、脱敏图片和移动端预检;
- 一次传输不可变产物并计算哈希;
- 远端只运行已经审计的固定发布器;
- 一次完成查重、写入和生产回读;
- 只有失败时才进入远端诊断。
这种方式既保留了远端 Profile 的权限隔离,也显著减少了重复推理和盲等。
安全边界
跨服务器 Hermes 协作至少需要守住以下边界:
- 远端 API 优先只监听回环地址,通过受控隧道访问;
- 不把 Token、Cookie、私钥或 SSH 密码写进提示词;
- 本地业务机器人不直接获得远端网站凭据;
- 草稿与发布模式分离,发布必须有当前任务的明确授权;
- 自动关联的官网列表、小程序 API 等表面必须一起确认;
- 写入前按标题和 slug 查重;
- 单次发布器不得自动重试 POST;
- 非零内容 ID 必须先落盘,再执行发布后回读;
- 失败时只回滚本次新建资源;
- 截图公开前必须完全遮挡身份、主机、端口、路径和凭据。
SSH 隧道解决的是通信安全,不会自动解决内容授权、命令审批、平台登录、验证码、重复发布和审计问题。这些仍需要各自独立的门禁。
适合使用这种架构的场景
这种模式适合:
- 不同服务器分别承载研发、内容、运维或数据 Profile;
- 本地聊天机器人需要调用远端专用 Skill;
- 敏感凭据必须留在资源所在服务器;
- 希望把任务编排与生产执行分开;
- 需要远端产物落盘和本地独立验收;
- 需要在断线、超时和失败后继续追踪真实状态。
如果只是偶发执行一个明确命令,直接使用受控 SSH 工具可能更简单。只有当远端需要自己的角色、资料、工具、Skill、会话和工作流时,才有必要调度另一个完整 Hermes Profile。
结语
这个案例中的“跨服务器通信”不是两个机器人在聊天,而是本地 Hermes 把一份受约束、自包含、可审计的任务交给远端 Hermes Profile;远端在自己的权限边界内执行,并用持久化结果和生产状态回答。
真正可靠的链路不是:
发出请求 → 收到一句成功
而是:
明确授权 → 安全传输
→ 远端受限执行 → 结果落盘
→ 本地独立回读 → 可验证完成
把机器人放到不同服务器上只是物理隔离;让每个机器人只掌握完成自身职责所需的权限,并让每一步都留下可以核对的结果,才是这套调度架构真正有价值的地方。